TL;DR: OpenAI publica dos modelos de pesos abiertos orientados al razonamiento: GPT-OSS de 20B y 120B. Estos modelos priorizan cadenas de pensamiento condensadas y optimizan el costo de inferencia. Pueden ejecutarse localmente mediante Ollama o contenedores.
1. Contexto y motivación
El ecosistema de modelos abiertos ha reducido la brecha con las ofertas cerradas. La estrategia detrás de GPT-OSS es liberar modelos que prioricen el razonamiento estructurado (reasoning-first) más que únicamente el rendimiento en tokens por segundo. Esto facilita:
- Auditoría y ajuste fino en dominios específicos (compliance, finanzas, gobierno).
- Despliegue on-premises o en edge, donde la soberanía de datos es crítica.
- Hibridación: usar modelos abiertos localmente y escalar a servicios gestionados solo cuando la complejidad lo requiera.
2. Modelos GPT‑OSS 20B y 120B
Rendimiento en NVIDIA Blackwell (GB200 NVL72 rack)
| Modelo | Parámetros | FP16 VRAM aprox. | 4-bit VRAM aprox. | Tokens/s aprox. | Enfoque |
|---|---|---|---|---|---|
| GPT-OSS 20B | 20B | ~40 GB | 11–12 GB | (estimado) 200k–250k | Razonamiento ligero / Serving edge |
| GPT-OSS 120B | 120B | ~240 GB | 65–70 GB | ~1 500 000 TPS | Razonamiento profundo / Planificación |
Por la escala del hardware y la proporción de parámetros, se estima que el modelo 120B podría generar varios cientos de miles de tokens por segundo. La cifra oficial para el 120B es ~1,5 millones TPS en GB200 NVL72.
Rendimiento en Apple Silicon (Mac M4 y M4 Max)
| Modelo | Parámetros | RAM necesaria (FP16 aprox.) | Tokens/s aprox. | Observaciones principales |
|---|---|---|---|---|
| GPT-OSS 20B | 20B | ~40 GB | ~0.3 (M4 16 GB) / ~160–180 (opt.) | Muy dependiente de la RAM; sin optimización es lento. |
| GPT-OSS 120B | 120B | ~240 GB | ~40 (M4 Max 128 GB) | Rápido con contextos pequeños; se ralentiza con >10k tokens. |
En Apple Silicon, la optimización mediante kernels para Metal, cuantización y gestión de contexto es clave para mantener un rendimiento fluido.
Rendimiento IA Corporativa - Autómata Digital
| Modelo | Hardware / Entorno | Prompt Tokens | Prompt TPS | Tokens generados | TPS generación | Total duración | Observaciones |
|---|---|---|---|---|---|---|---|
| GPT-OSS 20B | VPS con CPU AMD EPYC 7282 (12 núcleos / 24 hilos), 96 GB RAM, sin GPU (QEMU virtualizado) | 166 | 9.81 | 506 | 4.70 | 2m 4.67s | Ejecución 100 % en CPU |
Actualmente proveemos instancias capaces de servir modelos de IA sin aceleración por GPU a precios competitivos; creemos que esto es un paso importante para democratizar el acceso a la IA generativa.
3. Ejecución local con Ollama
La documentación oficial se encuentra en el sitio web de Ollama. Dependiendo de tu sistema operativo, podrías requerir descargar un instalador para Windows y Mac. En Linux, la instalación es tan simple como ejecutar un comando. Cabe destacar que la interfaz gráfica disponible para Mac simplifica notablemente el uso de estos y otros modelos en local.
Recomendación: Windows + WSL para GPU, o utilizar una Mac M3 o M4.
curl -fsSL https://ollama.com/install.sh | shUna vez instalado el software, se puede descargar el modelo deseado. En este ejemplo, se utilizará gpt-oss:20b desde la línea de comandos:
ollama run gpt-oss:20bSi deseas ver el proceso detallado, puedes añadir el parámetro --verbose:
echo "Escribe una frase corta sobre inteligencia artificial." | ollama run gpt-oss:20b --verboseSalida de ejemplo:
Thinking...
User wants a short sentence about AI in Spanish. We should provide a succinct phrase. Let's propose something like
"La inteligencia artificial redefine lo que la tecnología puede lograr." Or "La IA transforma nuestro futuro
digital." It's short. They didn't specify length but "corta". I'll provide 12-15 words. Probably okay.
...done thinking.

La inteligencia artificial transforma nuestro futuro digital.

total duration:       30.345792351s
load duration:        5.641760474s
prompt eval count:    76 token(s)
prompt eval duration: 7.827756169s
prompt eval rate:     9.71 tokens/s
eval count:           83 token(s)
eval duration:        16.875273238s
eval rate:            4.92 tokens/s
4. Benchmarks
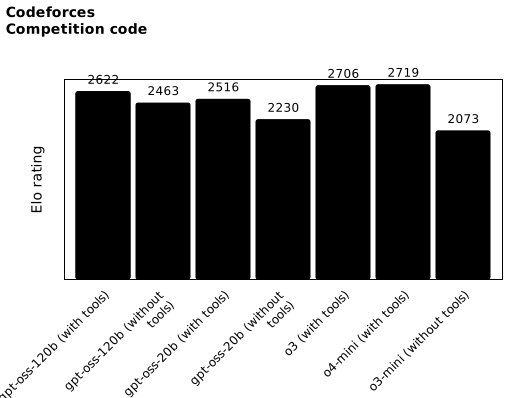
OpenAI ha realizado pruebas que sitúan a GPT-OSS por encima de otros modelos abiertos de tamaño similar. Los resultados muestran que el GPT-OSS 120B puede responder con capacidades cercanas a gpt-4o, mientras que el 20B se aproxima a gpt-3o. Se han evaluado en varios campos, por ejemplo:
Programación competitiva (Codeforces)
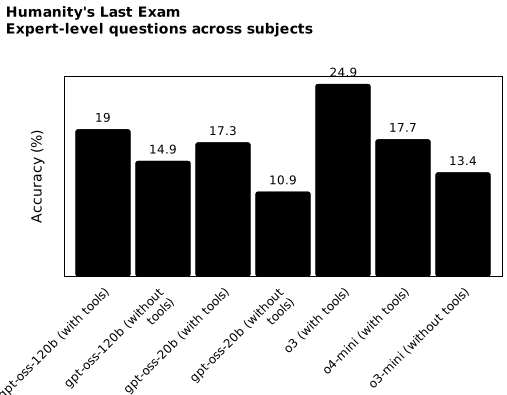
Puedes consultar más resultados en el blog oficial.
5. ¿Qué significa esto?
Más modelos implican más investigación. Tanto ingenieros, como instituciones o pequeños empresarios, pueden ahora acceder a tecnología de vanguardia, con mayor privacidad de datos y, lo más importante, opciones. Y esa es la clave: explorar lo que el mercado ofrece y elegir la solución que mejor se ajuste a cada caso de negocio.
Por mi parte, seguiré realizando pruebas y compartiendo en este laboratorio los resultados de mis investigaciones. Recuerden que en Autómata Digital trabajamos para mejorar la vida de todos.
Obrian HC
Innovation Chief Officer
Investigo y pruebo todos los días las nuevas tecnologías, veo como aplicarlas en Autómata y como beneficiaría a nuestros clientes.
Explora más o contáctanos
¿Listo para aplicar estas ideas? Escríbenos y diseñamos un piloto de automatización o inteligencia con impacto medible.